Statistiques originales : le levier SEO/GEO pour être cité par l'IA
Réponse rapide
Les statistiques originales sont des données propriétaires (études, benchmarks, corpus internes) publiées pour être citées. En SEO et GEO, elles peuvent contribuer à générer des backlinks et à devenir des sources référencées par ChatGPT, Perplexity et Google AI Overviews, qui privilégient généralement les contenus chiffrés, vérifiables et attribuables à une entité identifiée.
La plupart des articles de blog répètent les mêmes chiffres empruntés à d'autres. Résultat : ils apportent peu de valeur nouvelle et deviennent rarement des sources primaires. Or les moteurs génératifs — ChatGPT, Perplexity, Google AI Overviews — cherchent des points d'ancrage factuels attribuables. Un chiffre original, daté et méthodologiquement documenté, offre exactement ce type d'ancrage. Publier des statistiques issues de votre propre activité peut donc contribuer à la fois à votre référencement classique et à votre visibilité dans les réponses IA. Encore faut-il produire ces données proprement, les présenter de façon citable et les diffuser au bon endroit. Cet article détaille la méthode, ses limites et la manière de mesurer les effets dans Search Console. Selfhook peut faciliter cette démarche en transformant le corpus de ses utilisateurs — articles générés, performances observées, données d'usage — en études statistiques prêtes à être publiées sur WordPress.
Définition
On appelle statistiques originales des données quantitatives inédites, produites à partir de son propre corpus ou de ses propres mesures, publiées dans un format citable par les humains et par les moteurs de recherche génératifs.
Pourquoi les statistiques originales sont-elles citées par l'IA ?
Les moteurs de recherche génératifs construisent leurs réponses en agrégeant des sources qu'ils jugent fiables et vérifiables. Une donnée chiffrée pose un problème particulier : elle doit être attribuée à une origine. Contrairement à une opinion, un chiffre ne peut pas être paraphrasé sans risque, ce qui pousse généralement les systèmes comme ChatGPT ou Perplexity à citer la source d'où provient la statistique. C'est précisément ce mécanisme d'attribution qui rend les données originales intéressantes en Generative Engine Optimization. Une statistique reprise de dix autres sites perd sa valeur d'ancrage : le moteur ne sait plus à qui l'attribuer, ou cite la source la plus autoritaire, rarement vous. À l'inverse, une donnée que vous êtes le seul à posséder — parce qu'elle vient de votre corpus interne — n'a qu'une seule origine possible. Dans certains cas observés, cela augmente la probabilité que votre nom apparaisse dans la réponse générée. Ce raisonnement rejoint les principes E-E-A-T de Google : l'expérience et l'expertise se démontrent notamment par la production de données propres. Un éditeur qui publie « d'après l'analyse de 12 000 articles publiés via notre plateforme » signale une expérience de première main difficile à contrefaire. Cette signature d'autorité peut contribuer au positionnement classique tout en nourrissant les citations IA. Il faut toutefois rester mesuré. La citation n'est jamais recommandée : les moteurs génératifs évoluent, leurs critères d'inclusion restent partiellement opaques, et une donnée mal contextualisée peut être ignorée. L'objectif réaliste est d'augmenter la probabilité d'être retenu comme source, pas de l'assurer. Comme pour toute stratégie décrite dans notre guide sur la generative engine optimization, l'effet doit être observé sur la durée et confronté aux données réelles de trafic et de mentions.
Quelles données propriétaires peut-on transformer en statistiques ?
Presque toute activité numérique génère des données exploitables, à condition de les structurer. Le premier réflexe consiste à inventorier ce que vous mesurez déjà mais ne publiez pas. Un e-commerçant dispose de paniers moyens, de taux de retour et de saisonnalités. Une agence SEO possède des historiques de positionnement, des délais d'indexation observés et des taux de conversion par secteur. Un éditeur de contenu accumule des durées de rédaction, des scores de lisibilité Yoast et des performances par format d'article. Ces données brutes ne deviennent des statistiques citables qu'après agrégation et anonymisation. On ne publie pas les chiffres d'un client identifiable, mais une moyenne ou une distribution issue d'un échantillon suffisant. La taille de l'échantillon compte : un chiffre tiré de 30 observations sera moins crédible qu'un chiffre issu de plusieurs milliers, et devra être présenté comme une estimation prudente. Quelques catégories de données se prêtent particulièrement bien à ce traitement :
- Benchmarks de performance : temps moyen d'indexation, évolution de trafic observée après une action précise
- Comportements agrégés : taux de clics par type de titre, longueur d'article la plus performante selon la thématique
- Coûts et durées : temps de production moyen, coût par article, retour sur investissement estimé
- Distributions : répartition des scores de lisibilité, part des contenus atteignant un seuil de positions
Comment structurer une étude statistique citable ?
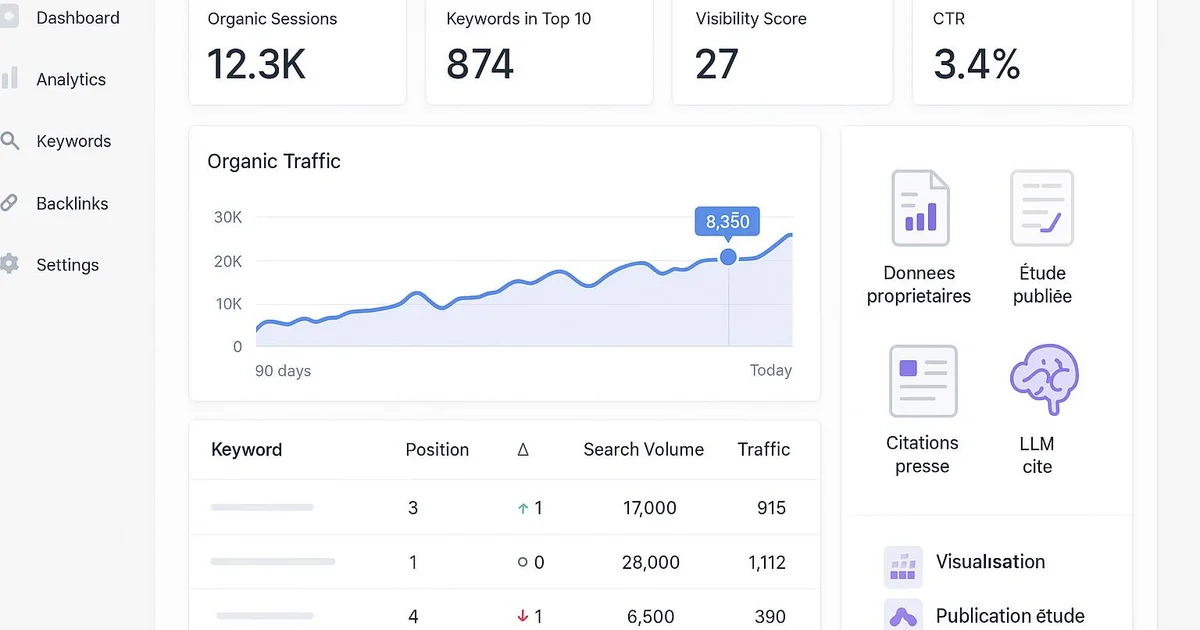
Une donnée n'est citable que si elle est vérifiable, et elle n'est vérifiable que si sa méthode est transparente. Toute étude statistique destinée au GEO devrait commencer par une note méthodologique claire : période couverte, taille de l'échantillon, source des données, mode de calcul et limites reconnues. Cette rigueur n'est pas cosmétique. Les moteurs génératifs, comme les lecteurs humains experts, accordent généralement plus de poids à un chiffre dont le contexte est explicite. La présentation joue ensuite un rôle déterminant. Un chiffre isolé dans un paragraphe dense est moins facilement extrait qu'un chiffre mis en avant, formulé en une phrase autonome et autoportante. La formulation idéale contient le sujet, le chiffre, l'unité et la source dans un même énoncé : « D'après l'analyse de 8 400 articles, la durée moyenne d'indexation observée était de 4,2 jours. » Cette structure est directement citable par ChatGPT ou Perplexity sans reformulation risquée. Le balisage technique renforce l'extractabilité. Des titres descriptifs, des tableaux HTML propres et, si pertinent, un balisage de données structurées aident Google à comprendre la nature statistique du contenu. Il est également utile de dater visiblement l'étude et de prévoir sa mise à jour : une donnée de 2024 perd de sa force en 2026, et les moteurs privilégient souvent la fraîcheur. Enfin, chaque statistique clé mérite d'être isolée sous forme de phrase-réponse en début de section, pour maximiser sa reprise en AI Overview ou en snippet. Cette approche rejoint les principes de contenu autoritaire et d'E-E-A-T : la crédibilité d'une donnée dépend autant de sa production que de sa mise en scène éditoriale. Une étude bien structurée peut ainsi servir simultanément le référencement classique, l'obtention de backlinks et les citations dans les réponses génératives, à condition d'être diffusée durablement.
Comment diffuser et faire circuler ses statistiques ?
Produire une donnée originale ne suffit pas : sa valeur dépend de sa circulation. Une statistique citable est d'abord une statistique découvrable. Le point de départ reste une page dédiée et pérenne sur votre site, structurée comme une ressource de référence plutôt que comme un article d'actualité. Cette page doit rester accessible dans le temps, car les citations et les backlinks s'accumulent progressivement. La diffusion externe amplifie ensuite l'effet. Les journalistes et rédacteurs recherchent des chiffres exclusifs pour illustrer leurs articles ; un communiqué de données ou une page « statistiques » régulièrement mise à jour peut attirer des liens éditoriaux naturels. Ces backlinks conservent leur valeur en SEO classique et, indirectement, peuvent renforcer l'autorité perçue de la source par les moteurs génératifs. Il ne s'agit pas d'affirmer que les liens seuls déclenchent une citation IA, mais qu'un ensemble cohérent de signaux augmente la probabilité d'être retenu. La reprise sur d'autres formats prolonge la portée d'une étude. Un même jeu de données peut alimenter une infographie partageable, un fil sur les réseaux professionnels, une vidéo courte ou une newsletter. Chaque reprise doit renvoyer vers la source primaire, afin de concentrer l'autorité sur une seule URL. Cette centralisation est importante : disperser une donnée sur plusieurs pages dilue le signal d'attribution. Il reste indispensable de mesurer les effets réels. Dans Search Console, on surveille l'évolution des impressions et des positions sur les requêtes liées à la donnée. Des outils comme Semrush aident à suivre les backlinks entrants, et une veille manuelle sur ChatGPT ou Perplexity permet d'observer si votre chiffre est cité et correctement attribué. Ces mesures, à collecter sur plusieurs mois, transforment une intuition en stratégie pilotable. Elles rejoignent la logique décrite dans notre guide sur la manière d'être cité dans ChatGPT.
Quelles sont les limites et les risques des statistiques originales ?
Publier ses propres données n'est pas sans contreparties, et un rédacteur sérieux doit les expliciter. Le premier risque est méthodologique : un échantillon trop petit, une période non représentative ou un biais de sélection peuvent produire un chiffre trompeur. Une statistique mal construite qui circule largement peut nuire durablement à la crédibilité de l'émetteur, surtout si elle est reprise puis contredite. La prudence impose de présenter systématiquement les chiffres comme des estimations issues d'un contexte précis, jamais comme des vérités universelles. Le deuxième risque concerne la confidentialité. Transformer un corpus interne en étude publique suppose une anonymisation rigoureuse. Publier des données agrégées ne doit jamais permettre de reconstituer les performances d'un client ou d'un utilisateur identifiable. Cette contrainte est autant juridique qu'éthique, et elle limite parfois le niveau de détail publiable. Un troisième point tient à l'attribution incertaine dans les moteurs IA. Même une donnée exclusive n'est pas recommandée d'être citée : ChatGPT, Gemini ou Perplexity peuvent intégrer le chiffre dans leur réponse sans nommer la source, ou l'attribuer à un site qui l'a repris. Ce phénomène, observé régulièrement, rappelle que le GEO reste un domaine en évolution où les mécanismes d'attribution ne sont pas entièrement contrôlables. Enfin, il existe un coût de maintenance. Une statistique vieillissante perd de sa force et peut même devenir contre-productive si elle contredit des chiffres plus récents. Une stratégie de données sérieuse implique donc un cycle de mise à jour régulier, avec conservation de l'historique pour montrer l'évolution. Ce travail continu, plus que la publication ponctuelle, distingue une source réellement autoritaire d'un coup marketing isolé. Reconnaître ces limites n'affaiblit pas la démarche : cela la rend crédible, ce qui est précisément le but recherché en E-E-A-T comme en GEO.
Comment mesurer l'impact de ses statistiques sur les citations IA ?
Mesurer l'effet d'une étude statistique demande de combiner plusieurs signaux, car aucun indicateur adapté ne capture à lui seul la performance en SEO et en GEO. Le socle reste Google Search Console : on y suit l'évolution des impressions, des clics et des positions moyennes sur les requêtes contenant ou entourant la donnée publiée. Une progression durable, corrélée à la date de publication, constitue un premier signal d'intérêt, à interpréter avec prudence car d'autres facteurs peuvent intervenir. Le suivi des backlinks complète cette lecture. Des outils comme Semrush ou RankMath permettent d'identifier les sites qui reprennent votre chiffre et de vérifier s'ils renvoient bien vers la source primaire. La qualité des domaines référents importe plus que leur nombre : quelques liens éditoriaux pertinents pèsent généralement davantage qu'une multitude de reprises automatiques. La mesure spécifiquement GEO reste la plus délicate. Il n'existe pas encore d'outil standardisé qui déclare avec certitude « votre statistique est citée par ChatGPT ». La méthode réaliste consiste en une veille manuelle et récurrente : interroger ChatGPT, Perplexity et Gemini sur des questions liées à votre donnée, puis noter si le chiffre apparaît et à qui il est attribué. Certains suivis d'audience détectent aussi le trafic référent provenant de ces plateformes, un indice indirect de citation. En consolidant ces observations sur plusieurs mois, on construit un tableau de bord qui distingue les études qui performent de celles qui stagnent. Cette boucle de mesure alimente les publications suivantes : on réinvestit dans les formats et les sujets qui génèrent réellement des citations et des liens. C'est cette discipline analytique, plus que l'intuition, qui transforme la production de statistiques originales en un actif de visibilité cumulatif, aligné avec les objectifs de generative engine optimization et de trafic organique classique.
Avec Selfhook, un éditeur peut transformer son propre corpus en études citables. La plateforme agrège des données anonymisées issues des articles générés et publiés — durées d'indexation observées, scores de lisibilité Yoast, évolution de trafic — puis la génération de contenu IA les met en forme en article statistique structuré. La publication WordPress automatisée met en ligne une page dédiée, datée et balisée pour l'extraction. L'audit SEO intégré vérifie la structure des titres et la présence de phrases-réponses autoportantes. Résultat : une ressource de données propriétaires, prête à attirer des backlinks et à être reprise par ChatGPT ou Perplexity, mise à jour sans repartir de zéro à chaque cycle.
Selfhook centralise génération de contenu, optimisation SEO/GEO, publication WordPress et suivi depuis un workflow unique.
Voir toutes les fonctionnalités →Un point négligé : les moteurs génératifs distinguent mal une donnée primaire d'une donnée relayée si les deux emploient une formulation identique. Pour maximiser l'attribution, variez la formulation par rapport aux reprises attendues et ancrez chaque chiffre à une entité nommée explicite (« selon l'analyse de [votre marque] »). Cette signature nominale, répétée de façon cohérente sur plusieurs pages et sources externes, renforce le lien statistique entre le chiffre et votre marque dans les modèles, davantage qu'un simple lien hypertexte isolé.
Sources
- Google Search Console — Suivi des impressions, clics et positions pour mesurer l'effet SEO d'une étude statistique.
- Documentation Google sur E-E-A-T — Cadre officiel expliquant pourquoi les données de première main renforcent l'autorité perçue.
- Semrush — Analyse des backlinks entrants et des domaines référents citant une statistique.
FAQ
Combien de données faut-il pour publier une statistique crédible ?
Il n'existe pas de seuil absolu, mais un échantillon de plusieurs milliers d'observations inspire généralement plus de confiance qu'une dizaine. L'essentiel est de publier la taille exacte de l'échantillon et de présenter le chiffre comme une estimation contextualisée plutôt qu'une vérité générale.
Une statistique originale garantit-elle une citation dans ChatGPT ?
Non. La citation dépend de facteurs partiellement opaques et évolutifs. Une donnée exclusive augmente la probabilité d'être retenue comme source, mais ChatGPT peut aussi intégrer le chiffre sans nommer l'origine. Le résultat doit être observé sur la durée.
Faut-il mettre à jour ses études statistiques ?
Oui, régulièrement. Une donnée vieillissante perd de sa force et les moteurs privilégient souvent la fraîcheur. Conserver l'historique permet en plus de montrer une évolution, ce qui renforce l'autorité de la source dans le temps.
Comment protéger la confidentialité des données clients ?
En agrégeant et en anonymisant systématiquement. On publie des moyennes ou des distributions issues d'un échantillon suffisant, jamais des chiffres permettant d'identifier un client ou un utilisateur précis. C'est une exigence à la fois juridique et éthique.
Une agence SEO gérant une centaine de sites WordPress a compilé, sur douze mois, les délais d'indexation observés après publication. Après anonymisation, elle a publié une page « Benchmark d'indexation 2026 » indiquant un délai médian estimé à 3,8 jours sur environ 6 200 URL. La page, structurée avec une note méthodologique et des phrases-réponses autoportantes, a été relayée par deux blogs spécialisés dans les six semaines. Dans Search Console, les impressions sur les requêtes « délai indexation Google » ont progressé sur le trimestre suivant. Une veille manuelle a repéré la reprise du chiffre dans une réponse Perplexity, avec attribution partielle à l'agence — un résultat encourageant mais à consolider sur la durée.
Chronologie
Avant 2020
Les statistiques originales servent surtout à obtenir des backlinks et des reprises presse dans une logique SEO classique.
2020-2022
Les featured snippets valorisent les chiffres bien formulés, incitant à isoler chaque statistique en phrase-réponse.
2023-2024
L'essor de ChatGPT et Perplexity fait des données attribuables un enjeu de citation dans les réponses génératives.
2025 et après
Le GEO institutionnalise les données propriétaires comme actif de visibilité, avec des méthodes de mesure encore en construction.
Un chiffre que vous êtes le seul à posséder n'a qu'une seule origine possible : c'est précisément cette unicité qui, dans certains cas, transforme une donnée interne en source citée par les moteurs génératifs.
Erreurs fréquentes
Recycler des chiffres empruntés
Reprendre des statistiques déjà publiées ailleurs prive votre contenu de tout pouvoir d'attribution auprès des moteurs IA.
Omettre la méthodologie
Sans période, échantillon et mode de calcul, une donnée n'est pas vérifiable et perd sa crédibilité auprès des lecteurs et des moteurs.
Disperser la donnée sur plusieurs pages
Publier le même chiffre sur plusieurs URL dilue le signal d'attribution au lieu de concentrer l'autorité.
Négliger la mise à jour
Une statistique périmée peut devenir contre-productive si elle contredit des chiffres plus récents et fiables.
Promettre une citation recommandée
Aucune donnée n'assure d'être citée par l'IA ; présenter cela comme certain nuit à la crédibilité de la démarche.
Articles du même cluster
Guides de référence
Automatisez avec Selfhook
Conclusion
Les statistiques originales constituent l'un des rares leviers qui servent simultanément le SEO classique, l'acquisition de backlinks et les citations dans les moteurs génératifs. Leur force vient de leur unicité : une donnée que vous seul possédez n'a qu'une origine possible. Mais la démarche exige rigueur méthodologique, anonymisation, mise à jour régulière et mesure continue dans Search Console et via une veille IA. Aucune citation n'est recommandée ; l'objectif réaliste est d'augmenter la probabilité d'être retenu comme source. Selfhook peut structurer cette production en transformant le corpus de ses utilisateurs en études publiables, mises à jour et prêtes à devenir des références citables dans le temps.
Prêt à automatiser votre contenu SEO ?
Découvrez comment Selfhook peut vous aider à créer et publier du contenu SEO de qualité
Commencer gratuitement