Crawlabilité LLM et robots.txt : SEO pour l'ère de l'IA
Réponse rapide
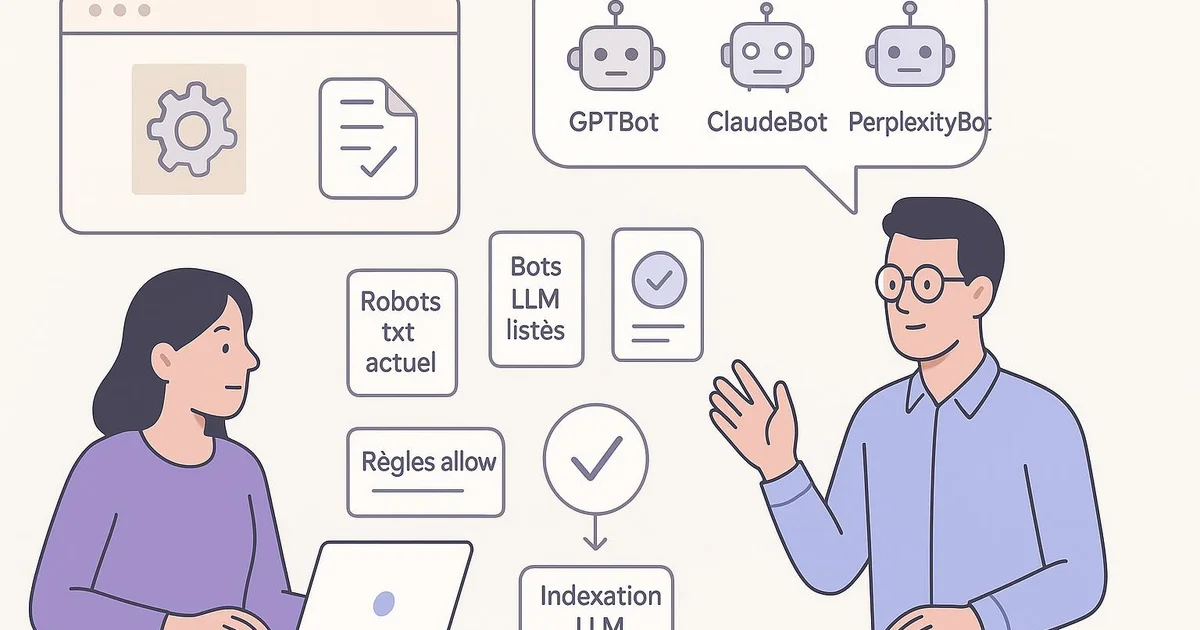
La crawlabilité LLM désigne la capacité des bots d'IA (GPTBot, ClaudeBot, PerplexityBot) à accéder à vos pages via le fichier robots.txt. Autoriser ces agents peut contribuer à ce que votre contenu soit indexé par les modèles de langage et cité dans des réponses génératives, alors qu'un blocage limite cette visibilité dans certains cas.
Le fichier robots.txt a longtemps servi à guider les crawlers de moteurs de recherche classiques comme Googlebot. Depuis l'essor des moteurs génératifs, une nouvelle catégorie d'agents s'y invite : GPTBot d'OpenAI, ClaudeBot d'Anthropic ou PerplexityBot. Leur présence soulève une question stratégique pour tout éditeur WordPress : faut-il les autoriser ou les bloquer ? La réponse dépend de la thématique, du modèle économique et des objectifs de visibilité. Bloquer ces bots protège certes le contenu d'un usage d'entraînement, mais réduit aussi, dans certains cas, les chances d'être cité dans ChatGPT, Perplexity ou Gemini. À l'inverse, une configuration ouverte peut contribuer à renforcer la présence dans les réponses génératives. Cet article analyse le fonctionnement de ces agents, les arbitrages possibles et la manière dont un outil comme Selfhook vérifie que votre robots.txt n'entrave pas involontairement l'indexation par les LLM.
Définition
La crawlabilité LLM est la capacité pour les robots d'exploration des modèles de langage à accéder, lire et indexer les pages d'un site web, une accessibilité largement déterminée par les directives du fichier robots.txt.
Comment les bots LLM interprètent-ils le robots.txt ?
Les crawlers des modèles de langage suivent, en théorie, le protocole d'exclusion des robots comme les crawlers traditionnels. Chaque agent s'identifie par un user-agent spécifique : GPTBot pour OpenAI, ClaudeBot et anthropic-ai pour Anthropic, PerplexityBot pour Perplexity, et Google-Extended pour l'usage génératif de Gemini côté Google. Le fichier robots.txt, placé à la racine du domaine, indique à chacun ce qu'il peut explorer via des directives Allow et Disallow. Il faut néanmoins distinguer deux usages souvent confondus. Certains bots crawlent pour l'entraînement des modèles, d'autres pour récupérer du contenu en temps réel lors d'une requête utilisateur — ce que fait par exemple Perplexity lorsqu'il cite une source. Bloquer un user-agent peut donc avoir des effets différents selon sa fonction. Un point mérite l'attention : le respect du robots.txt repose sur la bonne volonté déclarée des éditeurs de LLM, et son application observée varie selon les acteurs. Enfin, une directive mal formulée — un Disallow global appliqué par erreur à tous les user-agents — peut fermer l'accès sans intention explicite. C'est précisément ce type d'erreur de configuration qui, dans certains cas, prive un site de citations dans les moteurs génératifs sans que l'éditeur en soit conscient. Une vérification régulière, à croiser avec les logs serveur, reste la méthode la plus fiable pour comprendre qui accède réellement au contenu.
- GPTBot — crawler d'OpenAI pour l'entraînement et la récupération
- ClaudeBot / anthropic-ai — agents d'Anthropic
- PerplexityBot — exploration liée aux réponses citées de Perplexity
- Google-Extended — contrôle de l'usage génératif côté Google
Faut-il autoriser ou bloquer les crawlers d'IA ?
L'arbitrage entre ouverture et blocage n'a pas de réponse universelle : il dépend de la thématique du site et de sa stratégie de visibilité. Pour un éditeur qui vise la topical authority et cherche à être cité dans les réponses génératives, autoriser GPTBot, ClaudeBot et PerplexityBot peut contribuer à renforcer la présence de la marque dans ChatGPT ou Perplexity. Cette logique s'inscrit dans une démarche de generative engine optimization, où la citabilité du contenu devient un objectif à part entière, complémentaire du SEO classique mesuré dans Search Console. À l'opposé, un site dont le contenu constitue l'actif principal — bases de données propriétaires, contenus payants, œuvres originales — peut légitimement souhaiter bloquer l'usage d'entraînement pour préserver sa valeur. La nuance essentielle : bloquer un bot d'entraînement ne signifie pas nécessairement disparaître des réponses en temps réel, car certains agents dissocient les deux usages. Dans la pratique, beaucoup d'éditeurs adoptent une position intermédiaire, autorisant la récupération liée aux citations tout en surveillant l'évolution des politiques des fournisseurs. Il est également prudent de documenter chaque choix et de le revoir périodiquement, car le paysage des user-agents évolue rapidement — de nouveaux crawlers apparaissent, et les acteurs existants modifient leurs comportements déclarés. Une configuration figée aujourd'hui peut, dans quelques mois, ne plus correspondre aux réalités observées du trafic des bots. La décision gagne donc à être traitée comme un paramètre vivant plutôt que comme un réglage définitif.
Comment optimiser la crawlabilité LLM au-delà du robots.txt ?
Autoriser les bots ne suffit pas : encore faut-il que le contenu soit techniquement accessible et structuré pour être exploité. La crawlabilité LLM s'appuie sur plusieurs leviers qui prolongent les bonnes pratiques SEO connues. D'abord, un sitemap XML à jour aide les agents à découvrir l'ensemble des URLs pertinentes, ce que facilite une génération automatique du sitemap plutôt qu'une maintenance manuelle. Ensuite, la clarté du HTML compte : un contenu rendu côté serveur, avec des balises sémantiques et des données structurées, est généralement plus facile à interpréter qu'un contenu injecté par JavaScript après chargement. Les modèles de langage valorisent aussi la structure éditoriale — titres explicites, définitions concises, réponses directes en début de section — car ces éléments facilitent l'extraction de passages citables. C'est le principe même de l'optimisation de contenu pour les LLM : rendre chaque paragraphe autonome et compréhensible hors contexte. La vitesse de chargement et l'absence d'erreurs 4xx ou 5xx jouent également, comme pour Googlebot, puisqu'un bot qui rencontre des erreurs répétées réduit sa fréquence de crawl dans certains cas. Enfin, la cohérence entre le robots.txt, les balises meta robots au niveau des pages et les en-têtes HTTP X-Robots-Tag évite les signaux contradictoires. Une page autorisée dans le robots.txt mais marquée noindex envoie un message ambigu. L'optimisation efficace consiste donc à aligner l'ensemble de ces signaux pour offrir aux crawlers d'IA un chemin d'accès clair et un contenu directement exploitable.
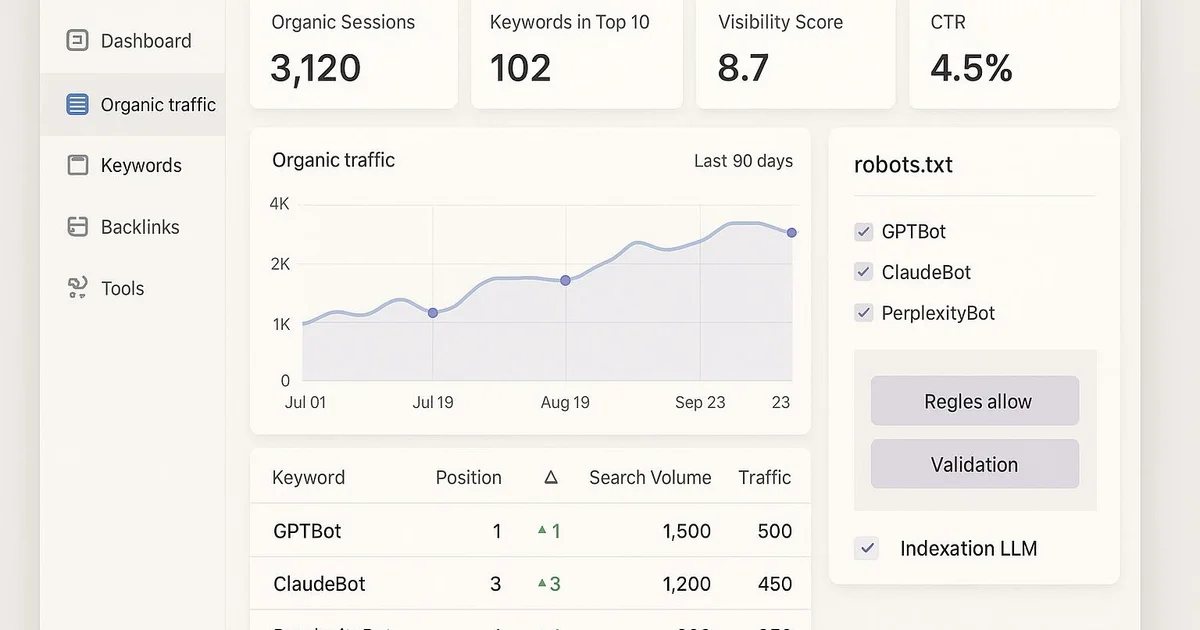
Selfhook intègre une vérification automatique du robots.txt lors de son audit SEO technique. À chaque publication WordPress automatisée, l'outil contrôle que les user-agents des principaux LLM — GPTBot, ClaudeBot et PerplexityBot — ne sont pas bloqués involontairement, et signale les directives Disallow susceptibles de limiter l'indexation générative. Combiné à la génération IA de contenu optimisé pour la citabilité et à la production d'un sitemap XML à jour, Selfhook aide ainsi à aligner accessibilité technique et qualité éditoriale. L'objectif n'est pas de garantir une citation, mais de retirer les obstacles de configuration qui, dans certains cas, empêchent un contenu pertinent d'être découvert par les moteurs génératifs.
Selfhook centralise génération de contenu, optimisation SEO/GEO, publication WordPress et suivi depuis un workflow unique.
Voir toutes les fonctionnalités →Chronologie
Avant 2023
Le robots.txt sert principalement à guider Googlebot et Bingbot dans une logique de moteur de recherche classique.
Mi-2023
OpenAI documente GPTBot et publie son user-agent, ouvrant la possibilité de contrôler explicitement l'accès au contenu d'entraînement.
Fin 2023
Google introduit Google-Extended pour dissocier l'usage génératif de l'indexation de recherche classique.
2024-2025
Anthropic et Perplexity clarifient leurs agents, et la distinction entre crawl d'entraînement et récupération en temps réel devient un enjeu stratégique.
2026
La crawlabilité LLM s'intègre aux audits SEO courants, traitée comme un paramètre vivant à surveiller régulièrement.
Une agence gérant un site média WordPress observait une absence quasi totale de citations dans Perplexity malgré un bon positionnement dans Search Console. L'audit a révélé un Disallow appliqué par erreur à l'ensemble des user-agents dans le robots.txt, hérité d'un ancien environnement de préproduction. Après correction — autorisation explicite de GPTBot, ClaudeBot et PerplexityBot, et régénération du sitemap XML — les logs serveur ont montré une reprise du crawl par ces agents sous une dizaine de jours. Sur les six semaines suivantes, l'équipe a observé une hausse estimée des apparitions du domaine comme source citée dans Perplexity, à confirmer sur une période plus longue. L'exemple illustre qu'un simple défaut de configuration peut neutraliser toute stratégie GEO.
FAQ
Bloquer GPTBot empêche-t-il d'apparaître dans ChatGPT ?
Bloquer GPTBot peut limiter l'exploration de votre contenu par OpenAI, ce qui réduit dans certains cas les chances d'être utilisé ou cité. L'effet dépend toutefois de la fonction du bot, entre entraînement et récupération, et du respect effectif du robots.txt par l'agent.
Le robots.txt est-il vraiment respecté par les bots LLM ?
Le respect du robots.txt repose sur la bonne volonté déclarée des éditeurs de LLM. Les principaux acteurs comme OpenAI et Anthropic affirment le suivre, mais l'application observée varie. Croiser les directives avec les logs serveur reste la méthode la plus fiable pour vérifier.
Quelle différence entre Google-Extended et Googlebot ?
Googlebot gère l'indexation pour la recherche classique, tandis que Google-Extended contrôle l'usage du contenu pour les fonctionnalités génératives comme Gemini et AI Overviews. Bloquer l'un n'affecte pas nécessairement l'autre.
Faut-il autoriser tous les bots LLM par défaut ?
Cela dépend de la thématique et du modèle économique. Un site cherchant la visibilité générative gagne généralement à les autoriser, tandis qu'un site à contenu propriétaire peut préférer restreindre l'usage d'entraînement. La décision gagne à être revue régulièrement.
Articles du même cluster
Guides de référence
Automatisez avec Selfhook
Conclusion
La crawlabilité LLM prolonge le SEO technique classique dans l'ère des moteurs génératifs. Le robots.txt reste un point de contrôle central : mal configuré, il peut priver un contenu pertinent de toute visibilité dans ChatGPT, Perplexity ou Gemini, souvent sans que l'éditeur en ait conscience. L'approche recommandée consiste à traiter les autorisations des bots comme un paramètre vivant, à aligner l'ensemble des signaux techniques et à mesurer les effets dans le temps plutôt qu'à figer une configuration. En automatisant la vérification du robots.txt, la génération de sitemap et l'optimisation éditoriale, Selfhook aide à retirer les obstacles qui limitent, dans certains cas, la découverte de votre contenu par les modèles de langage.
Prêt à automatiser votre contenu SEO ?
Découvrez comment Selfhook peut vous aider à créer et publier du contenu SEO de qualité
Commencer gratuitement